
Ollama 0.40.11 开始出声:macOS 本地语音生成,加一套只会回答「是/否/打分」的决策模型
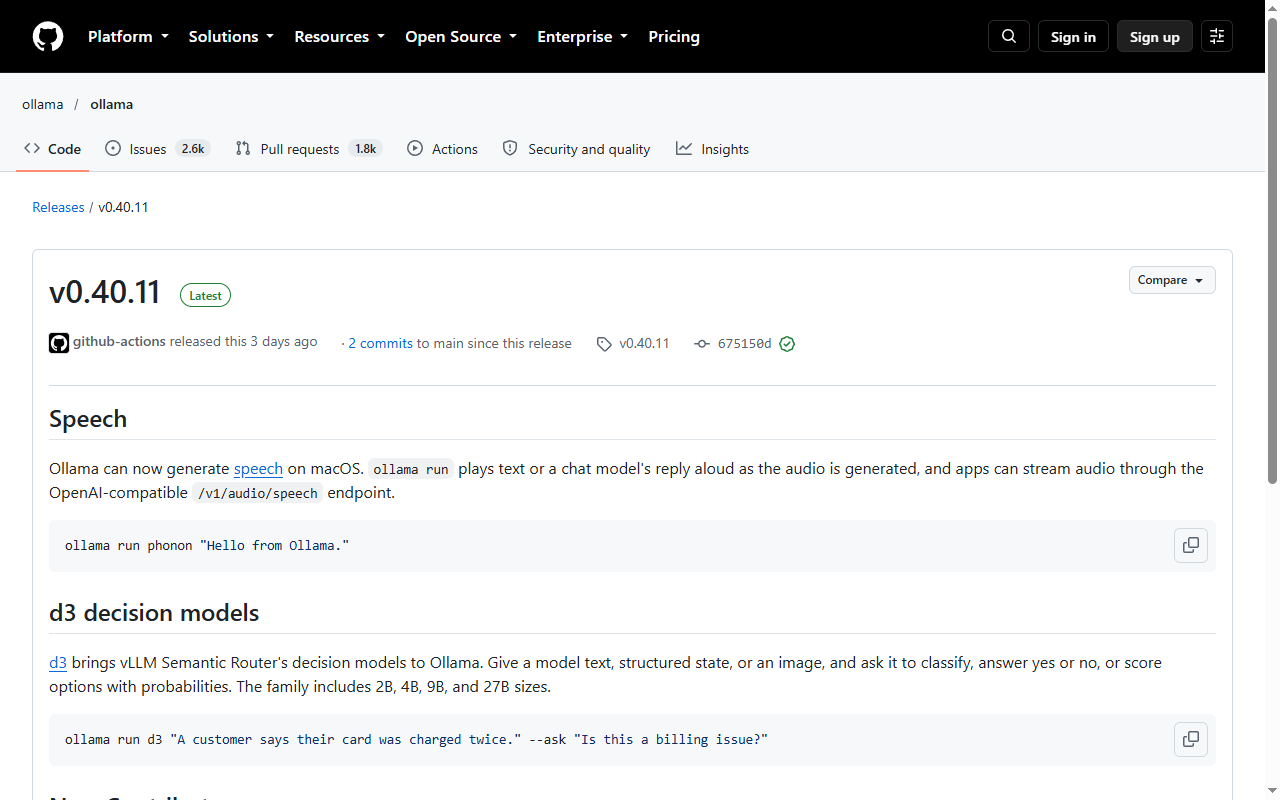
这个版本两件事:ollama run 能在 macOS 上边生成边播放语音,并暴露 OpenAI 兼容的 /v1/audio/speech;另外引入 d3 决策模型族,专门做分类、判断与概率打分。
Ollama 0.40.11 是 10 月 24 日发的。这一版两个新东西,方向完全不同:语音生成,和决策模型。
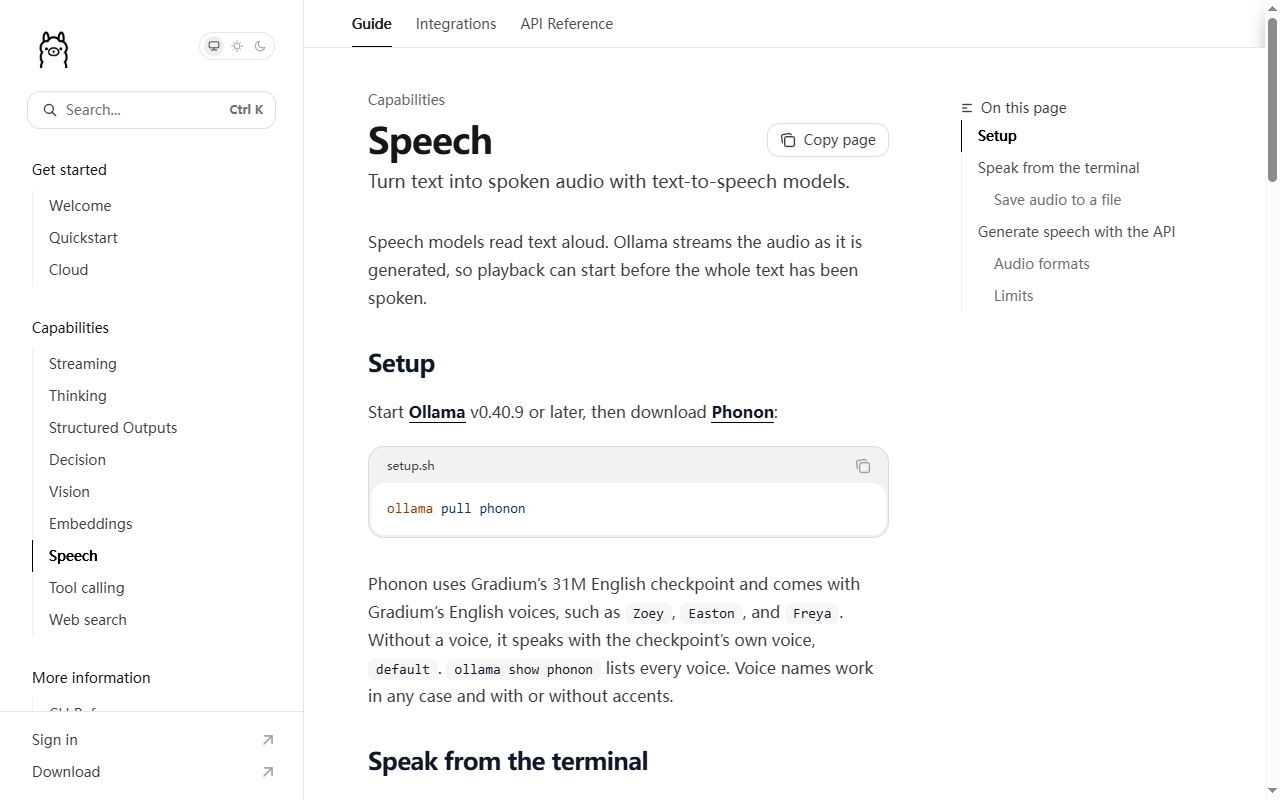
语音:边生成边播
ollama run phonon "Hello from Ollama."在 macOS 上,ollama run 现在会把文本或对话模型的回复直接念出来,而且是边生成边播 —— 不是等整段生成完再合成,而是音频流跟着 token 一起出来。对本地推理来说这个区别很实际:一段 200 字的中文,生成要几秒,如果等全文再合成语音,用户就是干等;边生成边播,第一句话几乎立刻能听到。
应用侧走 OpenAI 兼容接口:POST /v1/audio/speech,同样是流式。这意味着任何已经接了 OpenAI 语音接口的客户端,把 base URL 指到本地就能用。
为什么「本地 TTS」比看上去重要
云端 TTS 的问题不是贵,是位置:你说话的文本要离开机器。对个人助手、读屏、笔记朗读这类场景,语音化本来是最自然的需求,但一旦要上传文本,很多人就不做了。
本地 TTS 把这件事变成「装个模型」—— 和本地 LLM 是同一个逻辑:不是能力更强,是边界更清楚。
d3:只会分类和打分的模型
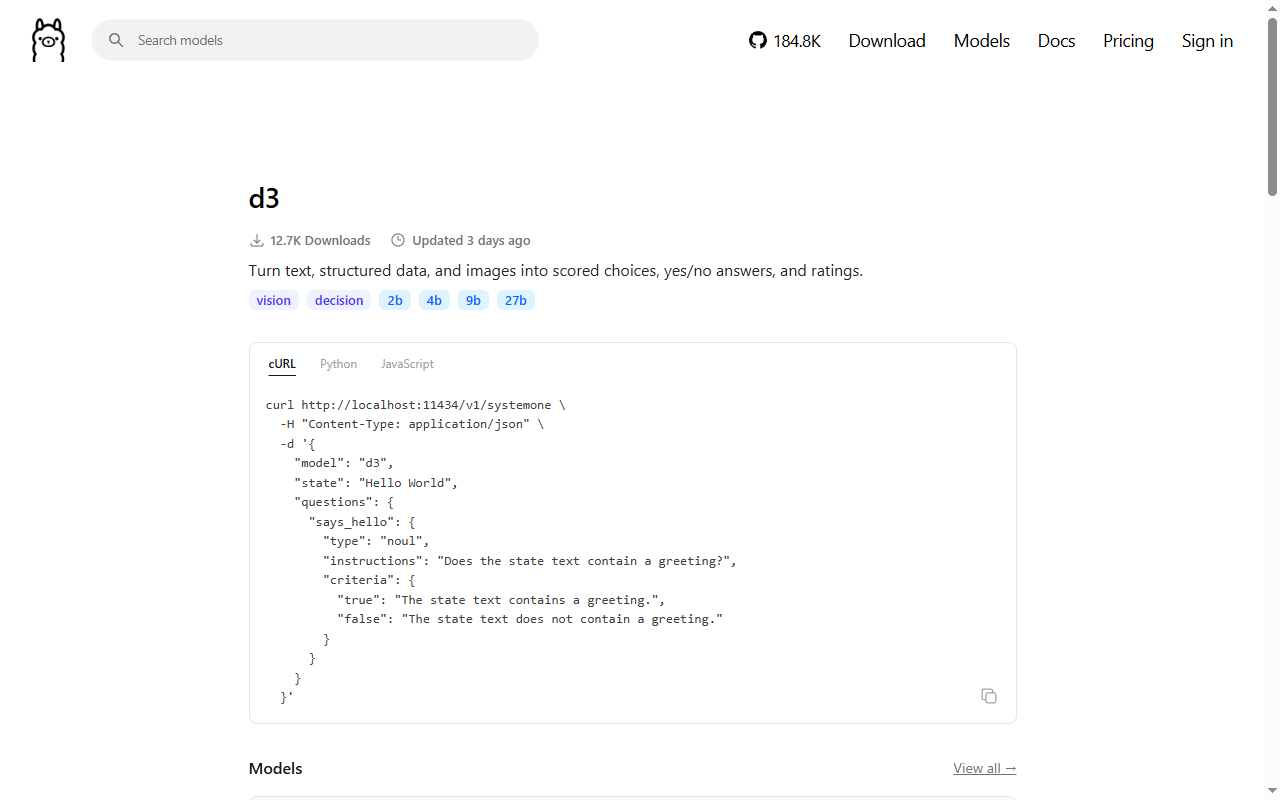
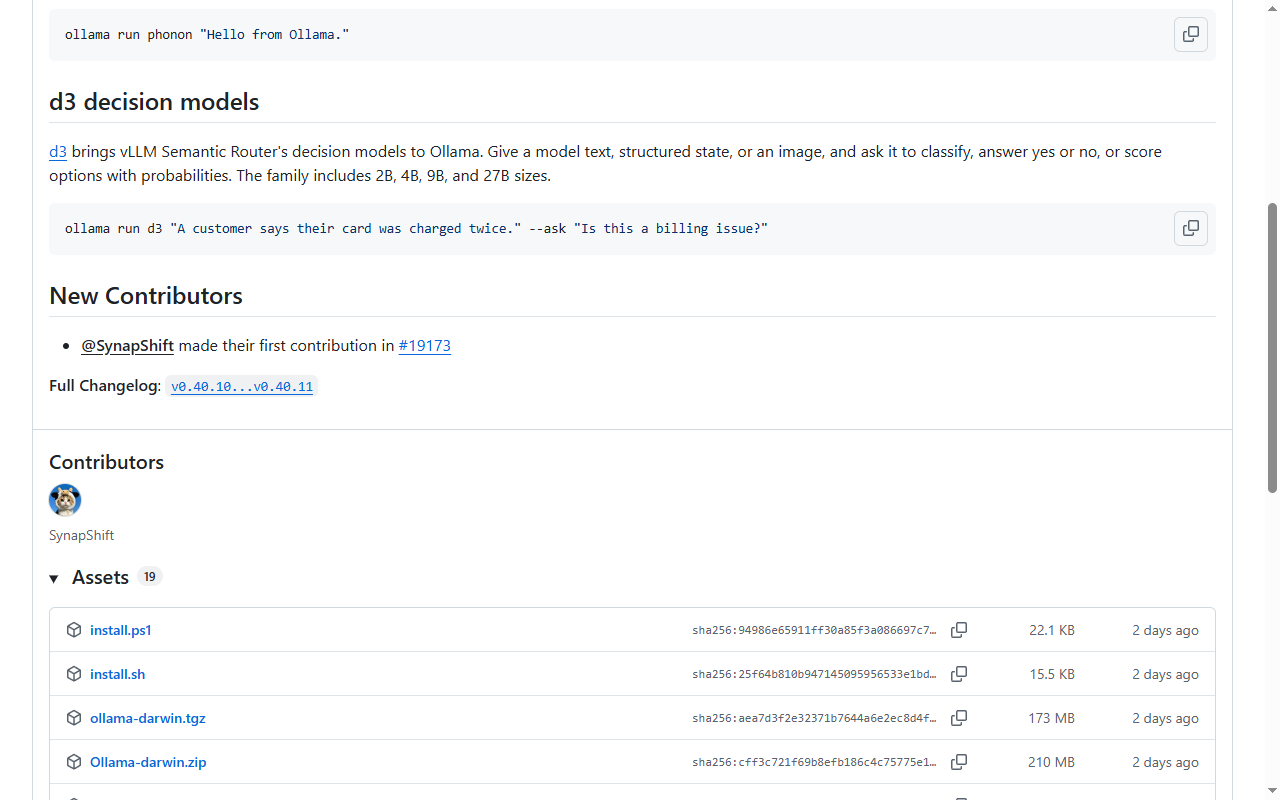
第二个新东西更有意思。d3 把 vLLM Semantic Router 的决策模型搬进了 Ollama:
ollama run d3 "A customer says their card was charged twice." --ask "Is this a billing issue?"输入可以是文本、结构化状态,或者图片;输出是三类之一:分类标签、是/否、或对候选选项的概率打分。模型有 2B、4B、9B、27B 四个尺寸。
这类模型的用法和「聊天模型」完全不同:
| 维度 | 聊天模型 | 决策模型 |
|---|---|---|
| 输出 | 自由文本 | 标签 / 布尔 / 概率分布 |
| 用途 | 生成内容 | 路由、分流、判定 |
| 失败模式 | 说得不像样 | 判错方向 |
| 需要的能力 | 表达 | 稳定与可复现 |
我关心的正是最后一行。决策模型的价值在稳定性,不在聪明:一个客服工单分流器,判对 95% 但每次判的理由都不一样,和一个判对 93% 但每次都一样的模型相比,后者在生产里更好用 —— 因为你可以围绕它做测试、做回归、做阈值。
这两个功能指向同一件事
把它们放在一起看,Ollama 这一版其实在补「应用需要的零件」:
- 语音输出 = 交互层(怎么把结果交给用户)
- 决策模型 = 控制层(在哪一步交给哪个模型)
本地推理过去只有「一个大模型 + 一段对话」这一种形态;现在开始出现「小模型做路由、大模型做生成、TTS 做输出」的流水线。这套流水线在云端早就有了,本地缺的正是小而专的模型与流式的音频出口。
我会怎么用
我的站点没有服务端,这类东西只能跑在自己机器上。真要用,顺序是:
- 先 d3,后语音。决策模型能直接嵌进脚本 —— 比如给抓取来的发布说明自动打标签(「这是安全更新 / 这是性能优化 / 这是文档」,三分类,2B 模型足够)。
- 语音当读屏用,而不是当产品功能。把文章念出来的价值是「通勤时能听」,不是「给访客放一段合成音」。
一个提醒:d3 这类模型要按「接口」对待,不要按「模型」对待。它输出的是结构化结果,所以你的代码应该校验它 —— 标签在不在枚举里、概率加起来是不是 1、置信度低的时候要不要转人工。把它当成一个可能返回脏数据的 RPC,而不是一个可靠函数。
版本节奏
从 0.40.9 到 0.40.11,三天三个版本。Ollama 的发布节奏一直很密,这也意味着别追最新版跑生产:除非你要的正是这一版里的语音或 d3,否则等两三个补丁版再动。
评论
…