
Ruff 0.17.2:新增一条「正则不必重复编译」的预览规则,外加一批误报修复
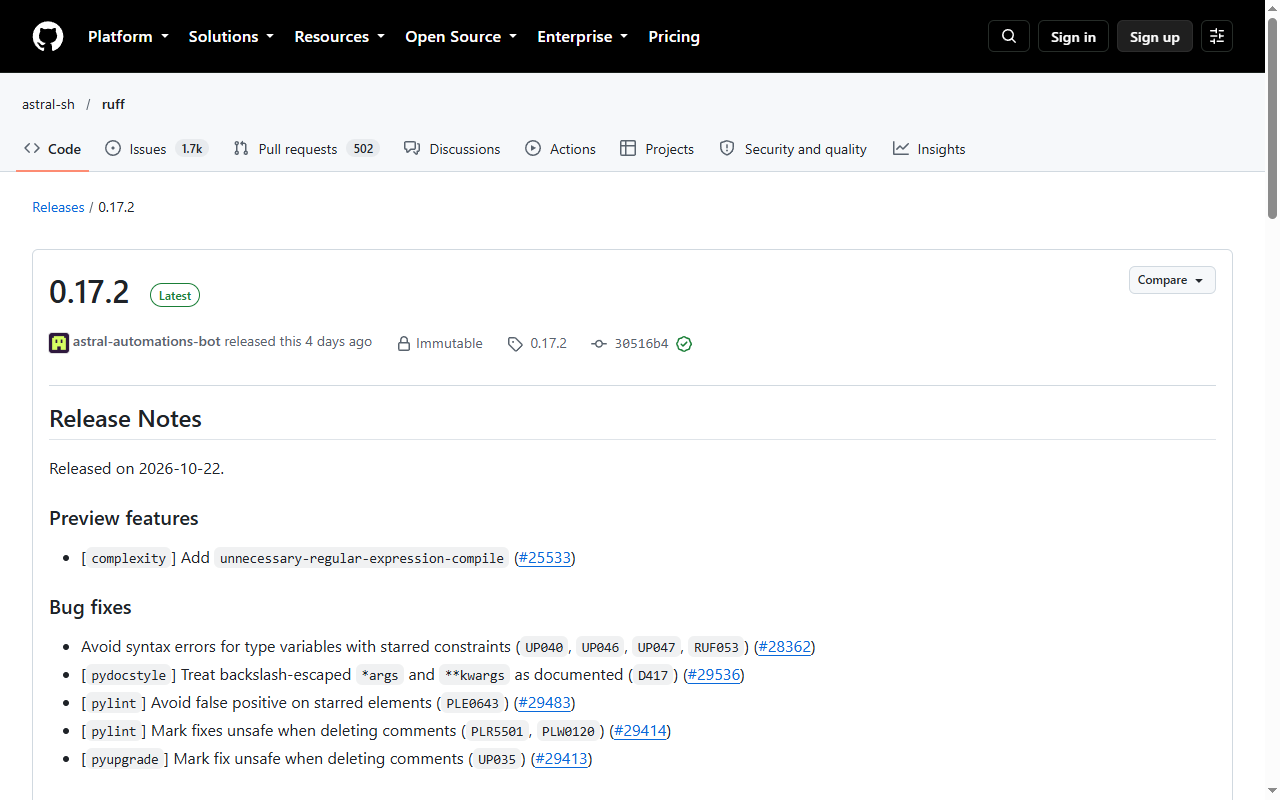
这个补丁版主要修误报:星号约束的类型变量、pydocstyle 的反斜杠转义、pylint 对星号元素的判断;另外把删除注释的修复标记为不安全,并做了两处性能优化。
Ruff 0.17.2 在 10 月 22 日发布。这类补丁版的更新说明通常很短,但 Ruff 的短说明里往往藏着「一个规则改了」这种实质信息。
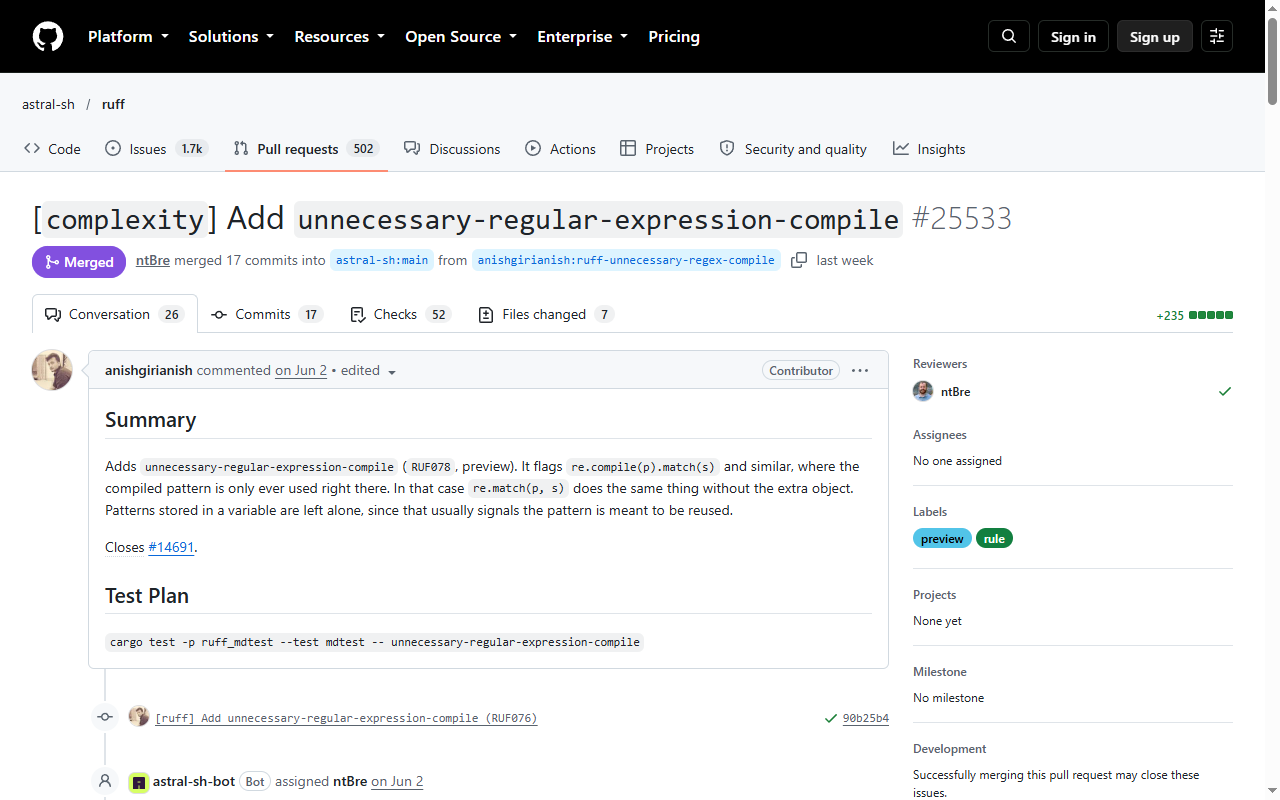
一条新的预览规则
[complexity]新增unnecessary-regular-expression-compile(#25533)
这条规则抓的是这种写法:
import re

# 每次调用都重新编译一遍
def is_phone(s: str) -> bool:
    return re.match(r"^\+?[0-9]{6,15}$", s) is not None

# 应该是:编译一次,复用
PHONE = re.compile(r"^\+?[0-9]{6,15}$")
def is_phone_fast(s: str) -> bool:
    return PHONE.match(s) is not None
Python 的 re 模块内部有缓存(默认 512 条),所以「每次编译」在简单脚本里几乎看不出来。但缓存是按 pattern 字符串做键的,动态拼出来的正则(比如带用户输入)会不断填满缓存,然后命中率掉下来,性能就变成断崖。
这条规则现在在预览通道(preview),需要显式开启:
# pyproject.toml
[tool.ruff.lint]
preview = true
select = ["RUF"] # 或按需加上这条规则的编号我的看法:预览规则该开,但别全开。Ruff 的预览通道里有些规则还在调整语义,全开会在升级时收到一堆「规则行为变了」的噪音。
顺带一句:这条规则只在「正则字面量出现在调用点」时才报。如果你确实需要动态拼 pattern,它不会误伤 —— 判断依据是「同一段源码里编译了常量 pattern 且没有复用」,而不是「用了 re.match」。
一批误报修复
这次修的问题有个共同点:都发生在「语法看起来奇怪但其实合法」的地方。
| 规则 | 修的问题 |
|---|---|
UP040 UP046 UP047 RUF053 |
带星号约束的类型变量会触发语法错误 |
D417 |
反斜杠转义的 *args / **kwargs 被当成「没写文档」 |
PLE0643 |
星号元素上的误报 |
PLR5501 PLW0120 UP035 |
删除注释时,修复应标记为不安全 |
前三条都是同一件事:Python 3.12+ 的泛型语法(def f[*Ts](...))让很多老规则的正则匹配失效了。规则的实现靠语法树,但「判断某个节点是不是某种形状」的辅助函数往往写得比较宽松,遇到新语法就误判。
第四条更值得注意:fix 会删掉注释,而注释不是语法树的一部分。所以「自动修复」可能悄悄删掉你写的一段解释 —— 现在这类修复被标记为 unsafe,意思是默认不自动应用,要显式加 --unsafe-fixes。
# 只应用安全修复(默认)
ruff check --fix .

# 允许改动语义/删注释的修复
ruff check --fix --unsafe-fixes .
这是格式化与 lint 工具的通用原则:能自动改的,只有那些「改完一定还是同一个意思」的东西。
两条性能优化
- lint 名称解析不再产生中间名字(#29506):每条规则的名字在匹配时会被反复查找,去掉中间分配能省下可观的内存与时间。
- 双向 Unicode 检查按 UTF-8 首字节预筛(#29561):这个检查要找出源码里的「双向控制字符」(就是那个著名的 Trojan Source 类问题),逐字符判断很贵;先看首字节就能排除绝大多数 ASCII。
第二条是典型的「便宜的条件先做」:99% 的字符是 ASCII,先排除它们,再对剩下的做贵检查。
我为什么还在用 Ruff
我维护的项目里 Python 不多,但每次用都觉得值:一个工具替代 flake8 + isort + pyupgrade + 部分 pylint,配置一份、速度一个量级。
0.17.2 这类版本不需要特别关注,但有一条建议:把 ruff check 的版本固定住。Ruff 的规则集在快速变化,CI 里用浮动版本会在某天突然多出几十条新报错 —— 而那时候你正在修别的东西。
评论
…