
扒了 DeepSeek 官方榜单:V4.1 Flash-1017 到底强在哪
我把 DeepSeek 官方更新日志里的基准表、性能-费用图和四个案例图全扒下来对照了一遍。结论是:这次更新主要补的是"动手干活"的能力,价格没涨,但长任务仍然会失败。
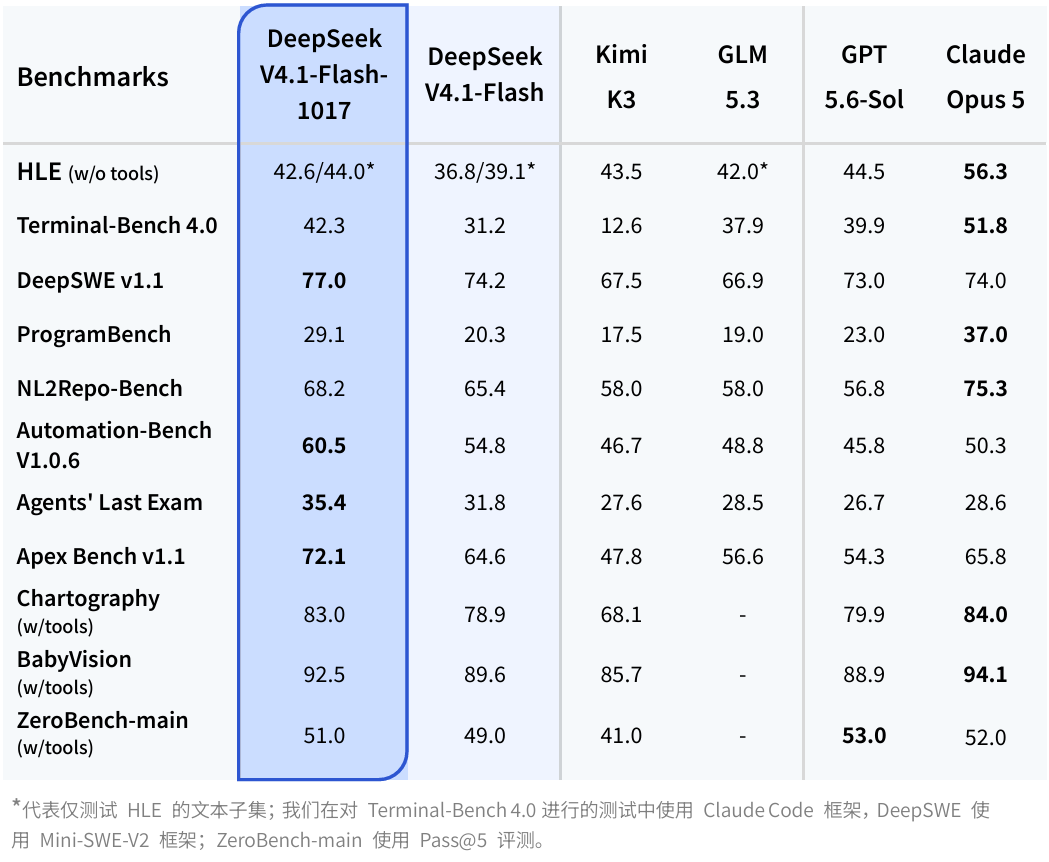
图:DeepSeek 官方更新日志里的 V4.1-Flash-1017 基准对比表(来源:api-docs.deepseek.com,截图于 2026-10-19)
DeepSeek 在 10 月 17 日把 V4.1 Flash 更新到了 V4.1-Flash-1017。官方新闻页的标题是“许愿式编程一键成真”,配了一张基准表、一张性能-费用图、四个案例动图。我把这些图都下载下来,对着数字看了一遍。
先说结论:这次不是“更聪明”,是“更能干活”。知识类指标涨得克制,Agent、终端、写程序这类“动手”指标涨得明显,而价格没动。
官方基准表:涨得最多的是“动手”项
官方表格里我挑出变化最大的几项:
| 基准 | 上一版 V4.1 Flash | V4.1-Flash-1017 | 变化 |
|---|---|---|---|
| HLE(无工具) | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Chartography(带工具) | 78.9 | 83.0 | +4.1 |
| BabyVision(带工具) | 89.6 | 92.5 | +2.9 |
| ZeroBench-main(带工具) | 49.0 | 51.0 | +2.0 |
这张表的信息量集中在两行:Terminal-Bench 4.0 涨 11.1 分、ProgramBench 涨 8.8 分。前者测的是在真实终端里完成多步任务,后者测的是从零写一个能跑的程序。它们共同指向一个能力:模型能不能自己动手、自己检查、自己修。
HLE 涨到 42.6 也很显眼,但别过度解读。HLE 的题目偏学术,42 分是“能答对四成”,离“可靠”还有距离。而且官方标注了带星号的 44.0 是纯文本子集成绩,口径不同,不能直接混着比。
性能-费用图:帕累托前沿往左下移了
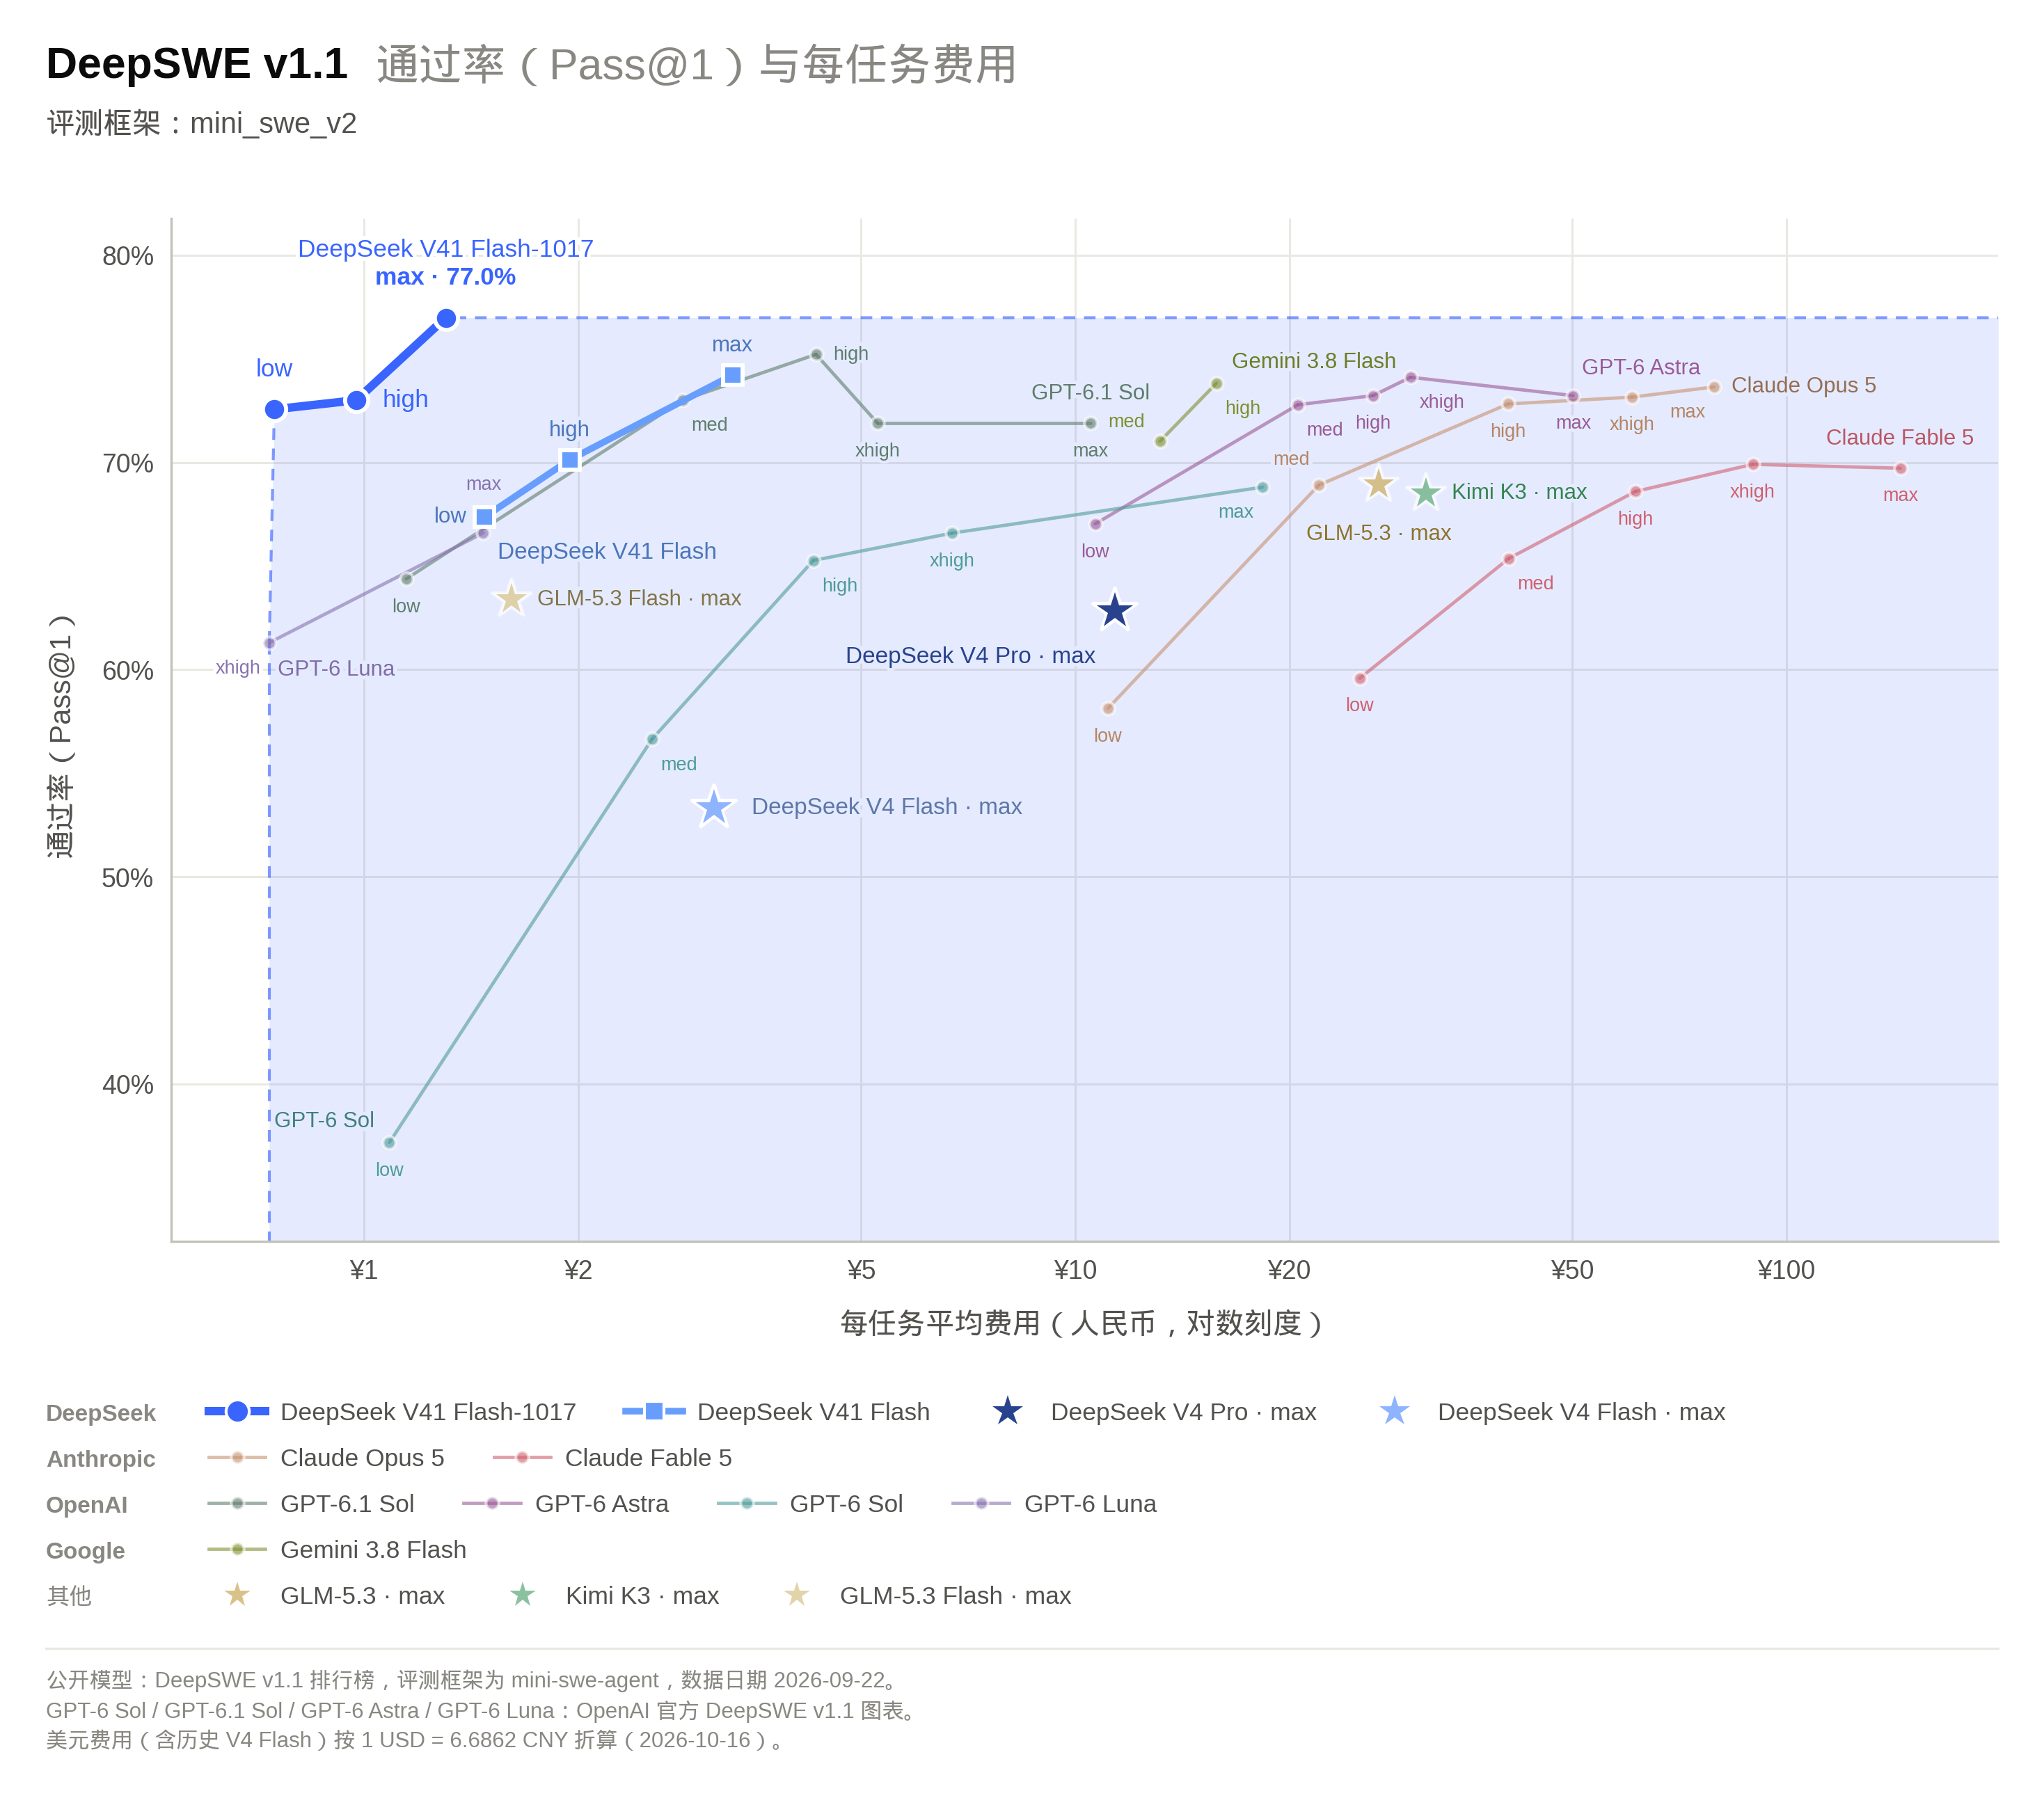
图:官方性能-费用帕累托图,横轴是成本、纵轴是性能(来源:api-docs.deepseek.com,截图于 2026-10-19)
第二张图是性能-费用曲线。官方说法是“在多个 Harness 下达到新的性能-费用帕累托最优”。翻译一下:同样的钱,现在能买到更高的性能;同样的性能,现在更便宜。
这张图比基准表更值得看,因为基准表只告诉你“能力上限”,帕累托图告诉你“性价比”。对个人开发者和小团队来说,后者才是决定用不用得起的因素。
官方还提到,这次同时缩短了任务运行时间和输出长度。输出短了,token 就少;token 少了,账单就低。这两件事叠在一起,才是“帕累托改进”的完整含义。
四个案例图:许愿式编程长什么样
官方放了四个案例动图,我截了前三张:
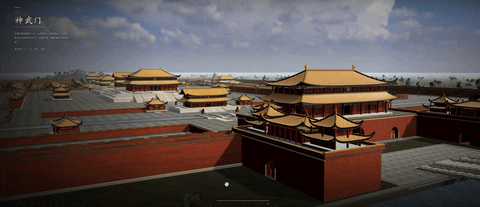
图:官方案例 1,从一句需求到可运行结果(来源:api-docs.deepseek.com,截图于 2026-10-19)
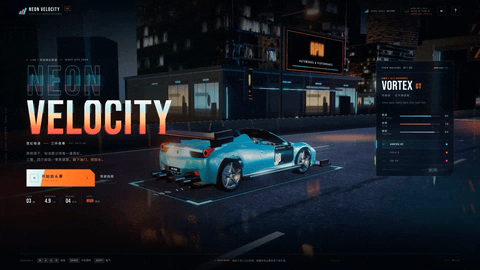
图:官方案例 2,多步骤任务的过程展示(来源:api-docs.deepseek.com,截图于 2026-10-19)
图:官方案例 3,带界面/交互的生成结果(来源:api-docs.deepseek.com,截图于 2026-10-19)
所谓“许愿式编程”,就是你描述想要什么,模型自己拆步骤、写代码、跑起来、看到结果不对再改。这四个案例展示的都是这条链路,而不是“生成一段代码片段”。
这也是为什么 Terminal-Bench 和 ProgramBench 的涨幅最关键:它们测的正是这条链路。案例图好看,但真正决定体验的是链路在失败时能不能自己收敛。
模型卡与接入方式
图:DeepSeek 官方社交卡片(来源:api-docs.deepseek.com,截图于 2026-10-19)
接入方式没变:模型名还是 deepseek-flash,API 调用方式和价格都不变。也就是说,你不需要改代码,只要请求打到最新模型就能吃到这次更新。
官方还建议把 DeepSeek Harness 升到 0.2.1-rc.1 以上,并提到针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等框架做了优化。这句话的潜台词是:同一个模型,外层脚手架的差异可能比版本差异还大。工具调用格式、上下文管理、失败重试策略,都会影响最终成功率。
搜索 API 与 GEO 过滤
更新日志里还有一段容易被忽略:DeepSeek 开放了自研搜索 API,索引千亿级网页,支持多语言,并专门提到对 SEO 作弊、GEO 操纵、低质 AIGC 做识别过滤。
这条对做 RAG 的人是利好:以前要自己拼搜索、清洗、去重,现在可以拿到相对干净的结果。但它也说明一个问题——大模型的答案越来越依赖它读到的网页,而网页是可以被操纵的。GEO 操纵那篇文章里我展开写了这件事。
我会怎么自测
官方榜单是厂商给的,落到自己业务上还得跑一遍。我一般做三组测试:
第一组,长任务。给一个真实小仓库,让它读 README、修一个测试、跑测试、提交。记录轮数和卡点。Terminal-Bench 42.3 说明这类任务成功率不到一半,自测能看出失败模式。
第二组,工具调用格式。给一个参数 schema 复杂的工具,看它漏不漏字段、类型对不对。小模型常见的问题不是不会调,而是调得“差不多”。
第三组,成本。记录输入输出 token 和耗时。Flash 单价低,但如果多跑五轮才成功,总成本可能反超更大的模型。便宜的是 token,贵的是轮次。
它不适合什么
- 超长上下文:Flash 的定位是够用,几万行的仓库还是得分块检索;
- 高精度推理:HLE 42.6 听着不错,但数学证明、复杂规划仍会一本正经地错;
- 多模态细节:原生视觉是加分项,但小字、手写、低分辨率截图的识别率明显下降;
- 长时间自主运行:跑几十步之后容易忘记早期约束,外层要有状态机和检查点。
官方没说、但看表能看出来的
第一,基准之间的口径不统一。官方表格里带星号的 HLE 44.0 是纯文本子集成绩,Terminal-Bench 4.0 用 Claude Code 框架测,DeepSWE 用 Mini-SWE-V2 框架测,ZeroBench 用 Pass@5。这些差异意味着:跨行比较没意义,只能同一行前后比。
第二,Pass@5 的分数会高估可用性。ZeroBench 51.0 是“五次里有一次对”,单次成功率远低于这个数。做产品时按单次成功率估,别按 Pass@5 估。
第三,“耗时缩短”没有单独列数字。官方只说任务运行时间和输出长度都降了,但没给具体百分比。如果你对延迟敏感,得自己压测。
第四,案例图是精选的。四个动图展示的是成功案例,失败重试、上下文溢出、工具报错这些不会放出来。看案例图要带着“这是最好情况”的预期。
还有一点:官方讲“许愿式编程”,但真实用户描述的需求往往不完整。模型需要主动追问,而不是猜。这一点在案例图里看不出来,得自己在产品里补澄清环节——否则生成得越快,返工越多。
接入前的三个实测建议
如果你准备切过去,我会先做三件事:
- 固定评测集:从自己的业务里抽 50 条真实请求,记录上一版的输出,切过去后逐条对比。别只看“感觉更好”。
- 压测并发:Flash 的卖点是吞吐,但你的配额和上游限流是另一回事。用生产同等的并发打一遍,看 P99 延迟。
- 算总账:把 token 单价、平均轮次、失败重试次数乘起来,算“每个成功任务”的成本,而不是“每百万 token”的价格。
这三件事做完,再决定要不要全量切。官方榜单负责告诉你“值得试”,不负责告诉你“值得换”。
我的判断
V4.1-Flash-1017 是一次典型的“执行层升级”:把 Agent、终端、写程序这些动手能力往上抬,同时用更短的输出和不变的价格把成本压住。
如果你在做 Agent、批处理、对成本敏感的产品,值得直接切过去;如果只做单轮问答,感知不会太强。
但官方榜单只是及格线。真正的差距在工程:你怎么组织上下文、怎么设计工具、怎么在失败时收敛。Flash 把及格线抬高了,剩下的还是得自己写。官方给的是起点,不是终点。真的。
评论
…