
Ollama 0.40.15:小米的 9B 代码模型进了库,还有一套只会回答「是/否/打分」的 AutoTrust
mimo-v2.6 是给代码和 agent 工作流准备的 9B 模型,一行命令就能拉;同一版还引入 AutoTrust 决策模型族(9b / 35b / 27b-vl),专门回答你给的那一个问题。
11 月 6 日,Ollama 发到 0.40.15。这个项目最近的节奏有点意思:它不再只是「本地跑模型的壳」,而是慢慢变成「本地该有的那些零件」的集散地。这一版塞进来两样东西,一个用来写代码,一个用来做判断。
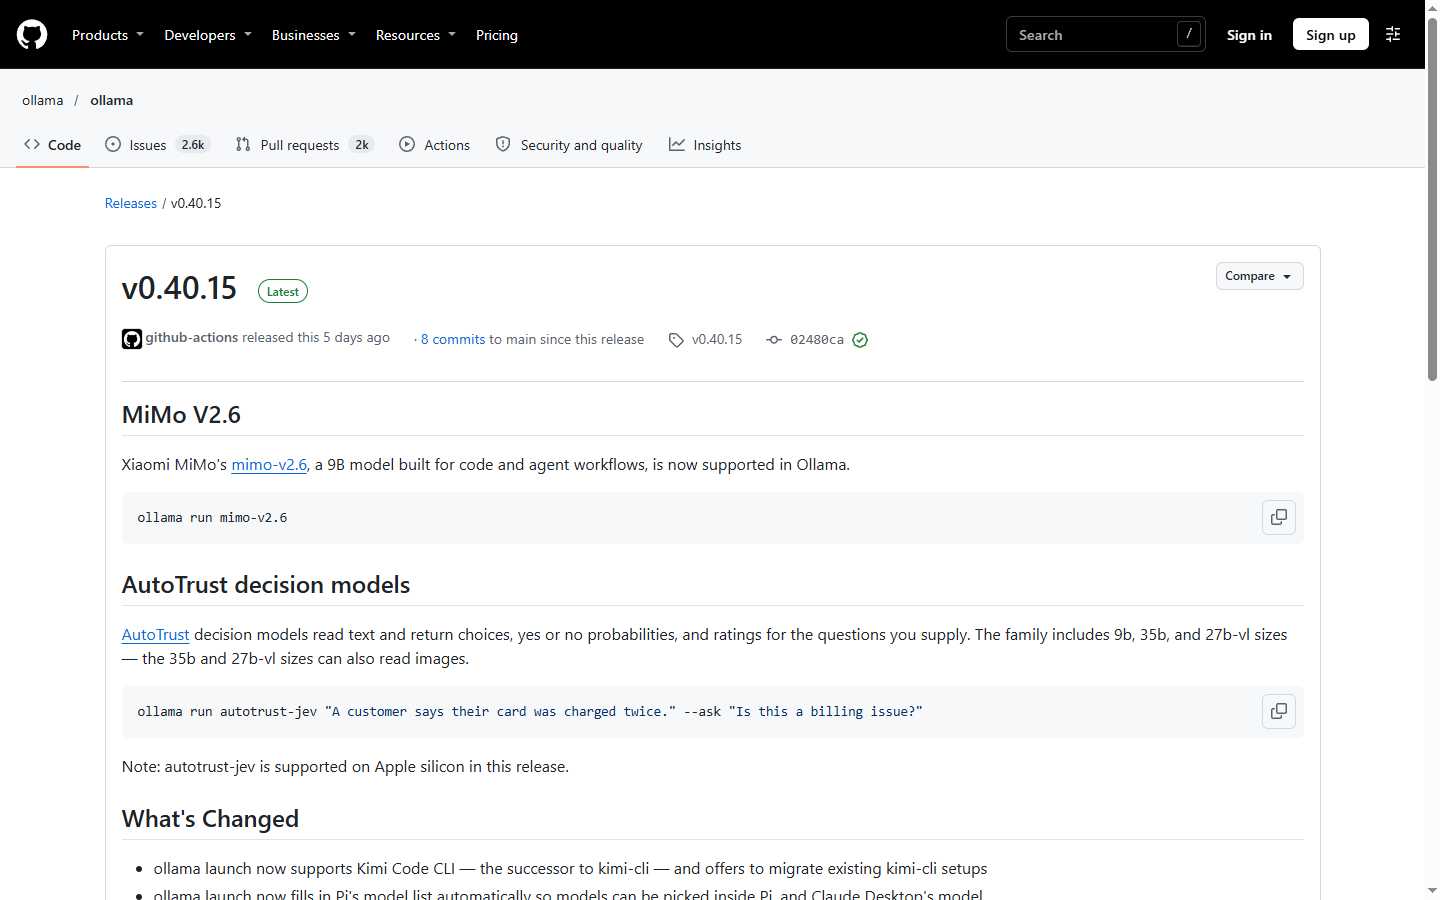
mimo-v2.6:9B,为代码和 agent 工作流调的
ollama run mimo-v2.6 就能拉下来。它是小米 MiMo 家的模型,全名 MiMo-V2.6-Distill-Qwen-9B,9B 参数、256K 上下文、下载包 6.6GB 起。
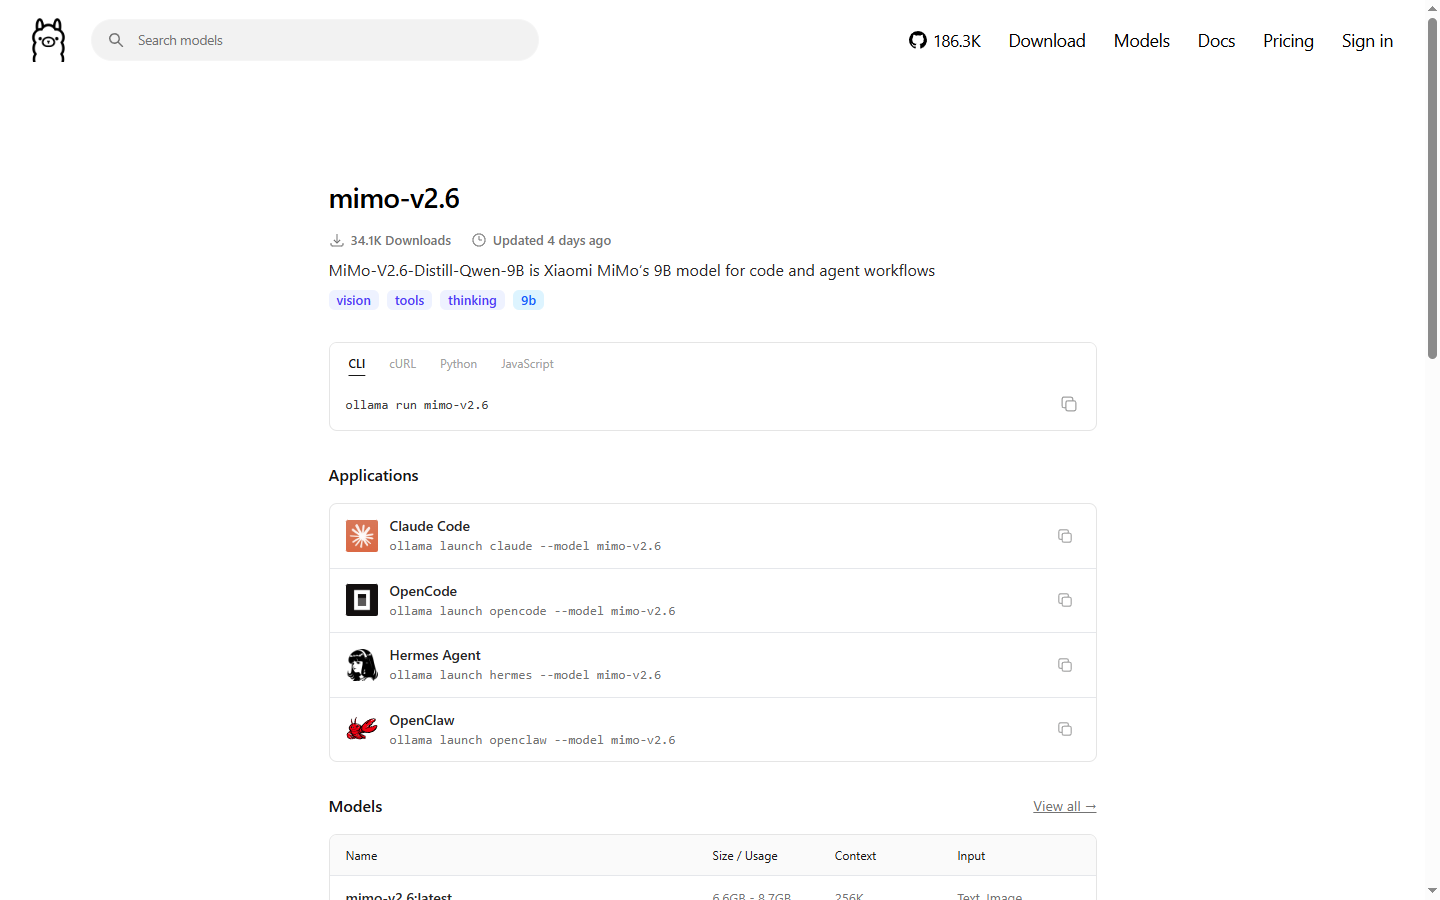
页面上列了几个它适配的客户端:Claude Code、OpenCode、Hermes Agent、OpenClaw,都是「模型要跑很多轮工具调用」的场景。这个定位比参数大小更值得注意 —— 它盯的是 agent 循环里的那几百次小请求,而不是一次长文生成。
我自己的体感是:9B 这个尺寸恰好卡在「能跑在 16GB 内存的机器上」和「不至于笨到不会改 JSON」之间。真要跑 agent,本地 9B + 云端大模型兜底,比全程云端便宜得多,也比全程本地靠谱得多。
AutoTrust:又一批「决策模型」
第二样东西是 AutoTrust,官方描述很短:读文本,按你给的问题返回选项、是/否概率、或者打分。
ollama run autotrust-jev "A customer says their card was charged twice." --ask "Is this a billing issue?"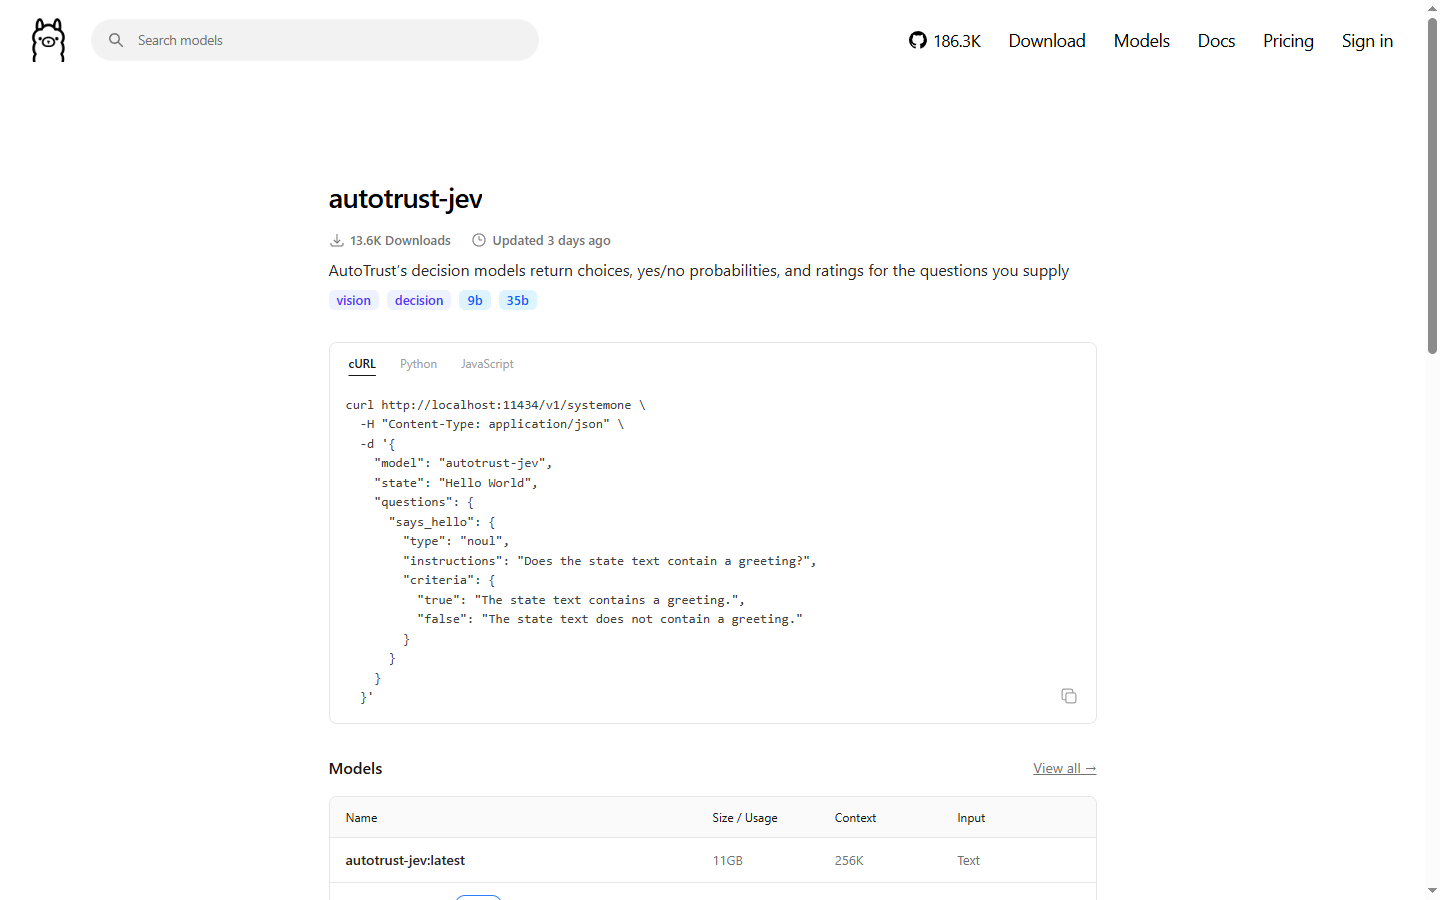
这个族里有 9b、35b、27b-vl 三个尺寸,后两个能读图。上一版(0.40.11)的 d3 也是这个路子,现在 AutoTrust 也进来了 —— 说明厂商认定「会分类的小模型」是一个独立品类。
我的看法很简单:这类模型的价值在稳定,不在聪明。 一个工单分流器,判对 93% 但每次理由一样,比判对 96% 但每次都不一样更好用,因为你可以围绕它写回归测试、调阈值、做灰度。你没法给一个「看心情」的模型写单元测试。
顺手修掉的几件事
发布说明里还有几条不太起眼、但对天天用它的人很实际:
ollama launch现在支持 Kimi Code CLI,并且会主动提议把老的 kimi-cli 配置迁移过来- Claude Desktop 的模型选择器终于显示 Ollama 的真实模型名(之前是一串内部标识,选起来像猜谜)
- Recurrent 与视觉 GGUF 模型可以同时服务多个请求了 —— 以前这类模型是串行的,一个请求占着,后面排队
- Qwen3 / Qwen3.5 的长上下文(YaRN)缩放问题修了
- 不带参数直接跑
ollama,会打开欢迎页
我会怎么用这两个
如果要落地,我会这样拆:
| 需求 | 用什么 | 理由 |
|---|---|---|
| 改一小段代码、补测试 | mimo-v2.6 | 9B 够快,能跑在笔记本上 |
| 代码 review 的「要不要拦」 | 一个决策模型 | 输出是布尔,能写进 CI |
| 长文档总结 | 云端大模型 | 本地 9B 会丢细节 |
说到底,本地推理这两年最大的变化不是模型变强了,而是开始有分工了。一个流水线里有小模型做路由、大模型做生成、决策模型做判定,这套东西在云端早就成了常识,本地去年还只有「一个大模型 + 一段对话」。0.40.15 这种版本,就是在把缺的零件一件件补上。
评论
…